궁극의 하드 드라이브: 2026년, DNA 데이터 저장이 드디어 현실이 된 이유
- Technology, AI & Data
- Exienent
- · 수정
**DNA 디지털 데이터 저장(DNA Digital Data Storage)**은 0과 1을 DNA의 네 가지 화학 염기로 바꿔 저장하는 기술로, 2026년 조용히 연구실을 벗어나 상업적인 엔터프라이즈 영역으로 넘어왔습니다. 일상적인 컴퓨팅에 쓰기엔 너무 느리지만, 장기 보관용으로는 자기 테이프나 하드 드라이브가 따라올 수 없는 밀도와 내구성을 제공합니다.
한 사람이 쌓는 데이터만 봐도 규모가 짐작됩니다. 수천 장의 고해상도 사진, 4K 비디오, 끊임없이 쌓이는 백업 파일만으로도 외장 하드는 금세 가득 찹니다. 이것을 인류 전체로 넓히면 문제는 분명해집니다. 우리는 (주로 AI와 쏟아지는 동영상들 덕분에) 전례 없는 폭발적인 속도로 데이터를 생성하고 있으며, 전통적인 서버 팜(Server Farm)을 지을 물리적인 공간과 희토류 금속, 그리고 전력이 말 그대로 고갈되고 있습니다. 이 위기 속에서 2026년 가장 의외의 구원자로 등장한 것이 바로 생물학입니다. 사이버펑크 스릴러 소설의 줄거리처럼 들리겠지만 현실입니다.
왜 전 세계의 데이터 저장 공간이 부족해질까?
전 세계의 기록 보관이 여전히 낡고 부피 큰 매체에 기대고 있기 때문입니다. 현재 전 세계의 '콜드 데이터(Cold Data, 역사적 기록 보관소, 금융 기록, 오래된 영화 등 매일 접근할 필요는 없지만 반드시 보관해야 하는 데이터)'의 상당수는 자기 테이프(Magnetic Tape)에 저장되어 있습니다. 네, 그 옛날 테이프 맞습니다. 부피가 엄청나게 크고, 시간이 지나면 성능이 저하되며(보통 10~20년마다 교체해야 함), 이 모든 테이프를 보관하기 위해 거대한 온습도 조절 창고를 유지하는 것은 환경적인 재앙에 가깝습니다.
만약 우리가 지금과 같은 추세로 계속 데이터를 만들어낸다면, 몇십 년 안에는 그 데이터를 모두 저장할 만큼의 실리콘이 지구상에 남아나지 않을 것입니다. 완전히 새로운 차원의 저장 매체가 절실합니다.
왜 DNA가 완벽한 하드 드라이브일까?
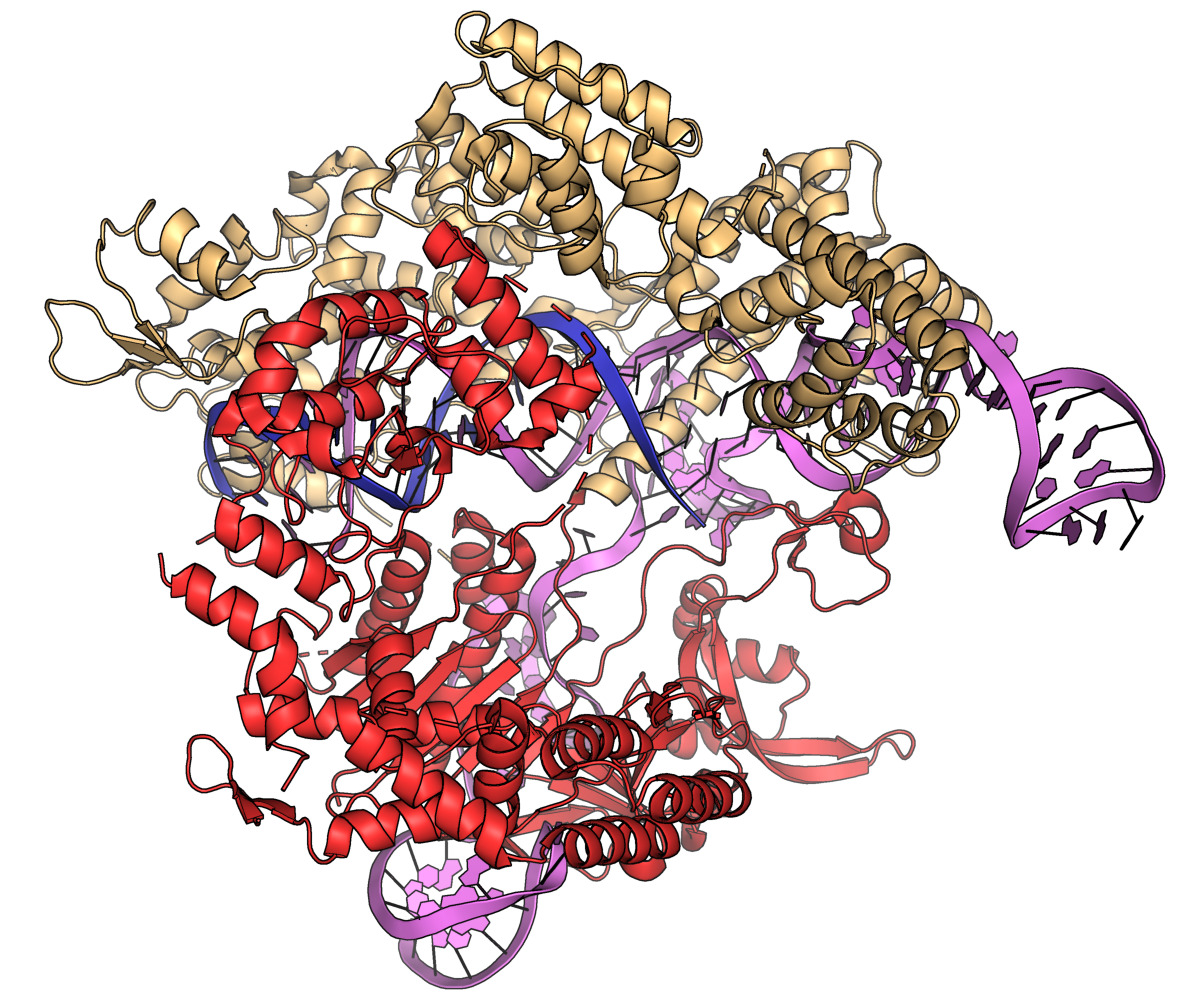
DNA는 밀도, 내구성, 판독 기술의 지속성 모두에서 인공 저장 매체를 앞섭니다. 대자연은 수십억 년 동안 데이터 저장 방식을 다듬어 왔고, 그 결과물인 DNA는 공학적인 관점에서 볼 때 진정한 걸작입니다. DNA를 단순한 생물학적 물질이 아니라 '정보 기술'로 바라보기 시작하면, 그 스펙은 입이 떡 벌어질 정도입니다.
- 극강의 저장 밀도: DNA는 믿을 수 없을 정도로 촘촘합니다. 이론적으로 단 1그램의 DNA에는 약 215페타바이트(2억 1,500만 기가바이트)의 데이터를 저장할 수 있습니다. 감이 잘 안 오시나요? 현재 인터넷 전체의 데이터를 신발 상자 하나 크기의 DNA에 전부 구겨 넣을 수 있다는 뜻입니다.
- 영원한 내구성: 일반적인 하드 드라이브나 USB 메모리를 서랍에 방치해 두면 15~20년 후에는 데이터를 읽을 수 없게 될 확률이 높습니다. 반면 DNA는 서늘하고 건조한 상태로만 보관하면 수천 년 동안 유지됩니다. 우리는 영구 동토층에서 수천 년 동안 꽁꽁 얼어붙어 있던 매머드의 DNA도 아무렇지 않게 읽어내고 있으니까요.
- 영구적인 호환성: 지구상에 인류가 존재하는 한, 우리는 DNA를 읽어내려는 기술과 욕구를 절대 잃지 않을 것입니다. 데이터를 읽을 하드웨어가 단종되어서 더 이상 사용할 수 없게 되는 '플로피 디스크의 비극' 같은 일은 DNA에서는 결코 일어나지 않습니다.
영화 한 편을 어떻게 DNA에 저장할까?
이진법 코드를 DNA 알파벳으로 번역한 뒤, 그 서열대로 DNA 가닥을 화학적으로 인쇄합니다. 2026년 현재 이 과정을 수행하는 기술은 매우 복잡하지만, 그 바탕에 깔린 논리는 놀라울 정도로 단순합니다.
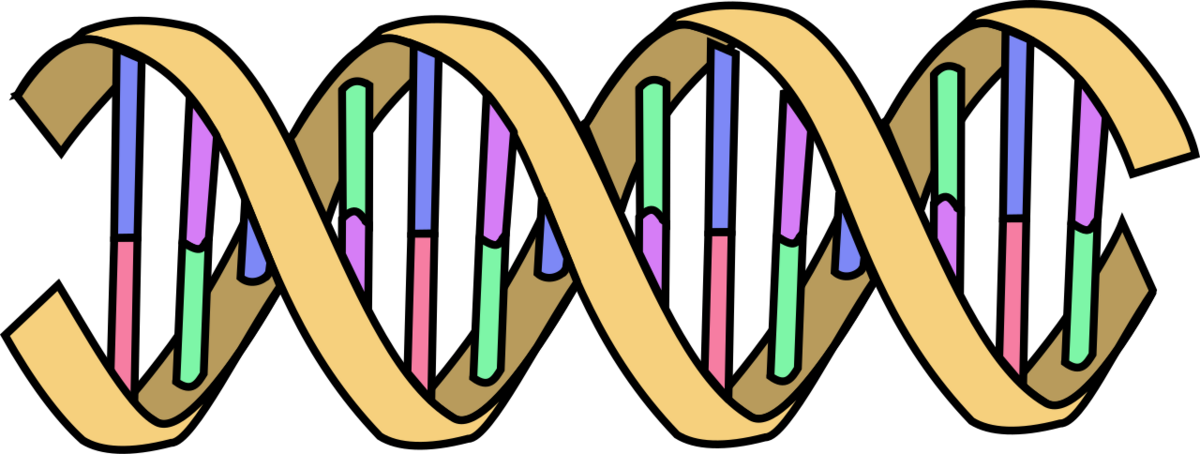
전통적인 컴퓨터는 0과 1의 조합인 이진법 코드를 사용합니다. DNA는 아데닌(A), 시토신(C), 구아닌(G), 티민(T)이라는 네 가지 화학 염기로 이루어진 4진법 코드를 사용하죠.
파일을 저장할 때, 알고리즘은 단순히 디지털 이진법 코드(00, 01, 10, 11)를 DNA 코드의 알파벳(A, C, G, T)으로 번역합니다. 그러고 나면 'DNA 합성기'라는 기계가 이 염기 서열과 일치하는 실제 물리적인 합성 DNA 가닥을 화학적으로 인쇄해 냅니다. 그 결과물인 DNA는 시험관 바닥에 있는 하얀 먼지 한 톨처럼 보입니다.
데이터를 다시 꺼내보고 싶을 땐 어떻게 할까요? 그 하얀 먼지 톨을 DNA 시퀀서(병원이나 과학수사 연구소에서 쓰는 것과 똑같은 기계)에 넣습니다. 기계가 A, C, G, T 서열을 읽어내면 알고리즘이 이를 다시 0과 1로 번역하고, 짜잔—여러분의 파일이 화면에 나타납니다.
2026년, DNA 데이터 저장은 상용화됐을까?
네, 기업용 아카이빙 분야에서는 그렇습니다. 오랜 시간 동안 이 기술의 가장 큰 장벽은 '비용'이었습니다. DNA를 쓰고(합성) 읽는(시퀀싱) 과정은 천문학적으로 비싸고 고통스러울 정도로 느렸습니다.
2026년, 이 기술은 마침내 임계점을 넘었습니다. 바이오테크 스타트업들과 대형 IT 대기업들이 손을 잡고 합성 과정을 극적으로 자동화하고 크기를 줄여냈습니다. 이제 우리는 최초의 기업용 "DNA 아카이빙 서비스"를 목격하고 있습니다.
물론 아직 여러분의 노트북에 꽂을 DNA 하드 드라이브를 살 수는 없습니다. 데이터를 읽고 쓰는 데 여전히 몇 시간이 걸리기 때문에, 실시간으로 비디오 게임을 하거나 문서를 편집하는 용도로는 쓸모가 없죠. 하지만 원본 마스터 파일을 영구 보관하려는 영화사나, 수백만 명의 환자 기록을 다음 세기까지 안전하게 보존해야 하는 병원들에게 DNA는 갑자기 시장에서 가장 가성비가 좋고 안전한 선택지가 되었습니다.
우리는 지금 거대한 패러다임 전환의 가장자리에 서 있습니다. 우리의 디지털 삶을 생명체의 코드 그 자체에 저장함으로써, 인류의 지식은 실리콘 서버가 먼지로 바스러진 후에도 아주 오랫동안 살아남게 될 것입니다.