소버린 AI(Sovereign AI): 2026년 기업과 국가가 자체 인프라를 구축하는 이유
- Security, Business & Marketing, AI & Data
- Exienent
- · 수정
**소버린 AI(Sovereign AI, 주권형 AI)**는 초집중화된 퍼블릭 클라우드 대신 자체 인프라·데이터·인력으로 AI를 운영하는 것으로, 2026년 기업과 정부의 핵심 AI 트렌드입니다. 기업들은 IP 유출을 막고, 엄격한 데이터 현지화 규제를 지키고, 치솟는 API 비용에서 벗어나기 위해 AI를 다시 내부로 들여오고 있으며, 국가들은 AI 역량을 국가 안보 문제로 보고 있습니다.
몇 년 전만 해도 지배적인 분위기는 "무조건 거대한 모델이 최고이고, 클라우드만이 유일한 정답이다"였습니다. 가장 민감한 기업 데이터조차 소수의 빅테크 기업들이 호스팅하는 수조 개 파라미터의 중앙집중형 모델로 아무 거리낌 없이 전송했죠. 그 편리함은 부인할 수 없었지만, 한편으로는 조용한 불안감이 싹트고 있었습니다.
2026년이 된 지금, 기술의 내러티브는 공격적으로 방향을 틀었습니다. 기업 이사회와 정부 기술 위원회에서 가장 뜨겁게 논의되는 키워드는 에이전트 기능이나 추론 모델만이 아니라, 통제권을 다시 내부로 가져오려는 흐름인 소버린 AI입니다.
소버린 AI란 정확히 무엇인가?
소버린 AI는 국가나 대기업이 외국의 제공업체나 초집중화된 퍼블릭 클라우드에 의존하지 않고, 자체적인 인프라, 데이터, 인력, 비즈니스 네트워크를 사용하여 인공지능을 생산하고 운영할 수 있는 능력을 말합니다. 핵심은 '자율성'과 '통제권'입니다.
다시 말해, AI 모델이 회사의 독점적인 소스 코드, 환자의 의료 기록, 혹은 국가의 방위 전략 데이터를 처리할 때, 그 데이터가 결코 공개된 인터넷망을 타고 다른 국가의 관할권에 있는 서버로 전송되지 않는다는 뜻입니다. 하드웨어, 모델의 가중치(Weights), 추론 엔진까지 모든 것이 조직이 직접 소유하고 법적으로 통제하는 철저히 보호된 '울타리 안(Walled Garden)'에 머물게 됩니다.
기업들은 왜 2026년에 AI 인프라를 되찾으려 할까?
기술 스택(Tech Stack)의 주도권을 되찾으려는 움직임에는 세 가지 분명한 계기가 있습니다.
소버린 AI는 IP 유출을 어떻게 막나요?
모델을 완전히 로컬 환경에 두거나 아예 인터넷과 단절된 에어갭(Air-gapped) 환경에서 운영해 원천적으로 막습니다. 초창기에는 직원들이 무심코 회사의 기밀 코드나 영업 비밀을 퍼블릭 AI 챗봇에 붙여넣는 바람에, 회사의 귀중한 IP가 AI의 학습 데이터로 사용되어 버리는 대형 사고들이 뉴스 헤드라인을 장식했습니다. 기업들은 퍼블릭 엔드포인트로 데이터를 보내는 것 자체가 치명적인 보안 리스크라는 것을 뼈저리게 깨달았습니다.
데이터 현지화 규제는 AI에 어떤 영향을 주나요?
글로벌 데이터 현지화(Data Residency) 법규는 상상 이상으로 엄격해졌습니다. 예를 들어 유럽에서 사업을 한다면 의료 데이터는 절대 해당 지역을 벗어날 수 없고, 지역 고객의 데이터를 미국 기반의 범용 API 엔드포인트로 전송하는 것은 이제 많은 관할권에서 법적으로 불가능합니다. 소버린 AI는 데이터 센터를 물리적으로 소유하고 그 안에서 연산이 이루어지기 때문에, 규제 준수(Compliance) 요건을 기본적으로 충족합니다.
소버린 AI가 클라우드 API보다 저렴한가요?
대규모에서는 그럴 수 있습니다. 빅테크 기업의 추론(Inference) API는 가볍게 테스트해 볼 때나 저렴합니다. AI가 대규모 엔터프라이즈 워크플로우에 깊숙이 통합되면서 API 호출 비용은 천문학적으로 치솟았습니다. 고도화된 오픈소스 모델(LLaMA나 DeepSeek의 변형 모델 등)을 프라이빗 베어메탈 인프라에서 실행하는 것이 대규모 스케일에서는 훨씬 더 비용 효율적이라는 것이 증명되었고, 벤더 종속(Vendor Lock-in)과 불필요한 "클라우드 세금"도 피할 수 있습니다.
정부는 왜 소버린 AI에 투자할까?
국가들 역시 AI 역량이 곧 국가 안보와 직결된다는 사실을 인식하고 있습니다. 기업만의 이야기가 아닌 셈입니다.
국가의 중요 AI 워크로드를 다른 나라의 인프라에 의존하는 것은 2026년 현재 심각한 전략적 취약점으로 간주됩니다. 각국은 국가 주도로 거대한 '소버린 AI 팩토리'에 투자하고 있습니다. 현지 전력망으로 가동되는 현지 데이터 센터에서, 그 국가 고유의 언어, 문화, 가치관을 집중적으로 학습한 모델을 구동하는 것입니다.
이러한 지역화(Localization)는 전 세계가 서구권 인터넷 데이터 위주로 학습된 단일 모델에 의존할 때 발생할 수 있는 '문화적 획일화'를 방지하는 역할도 합니다.
소버린 AI는 인프라를 어떻게 바꾸고 있나?
베어메탈(Bare Metal)이 다시 대세가 되었습니다. 불과 몇 년 전만 해도 모두가 서버를 직접 소유하지 않는 '서버리스(Serverless)' 환경을 원했지만, 소버린 AI로의 전환은 하드웨어 시장에 흥미로운 나비효과를 일으켰습니다.
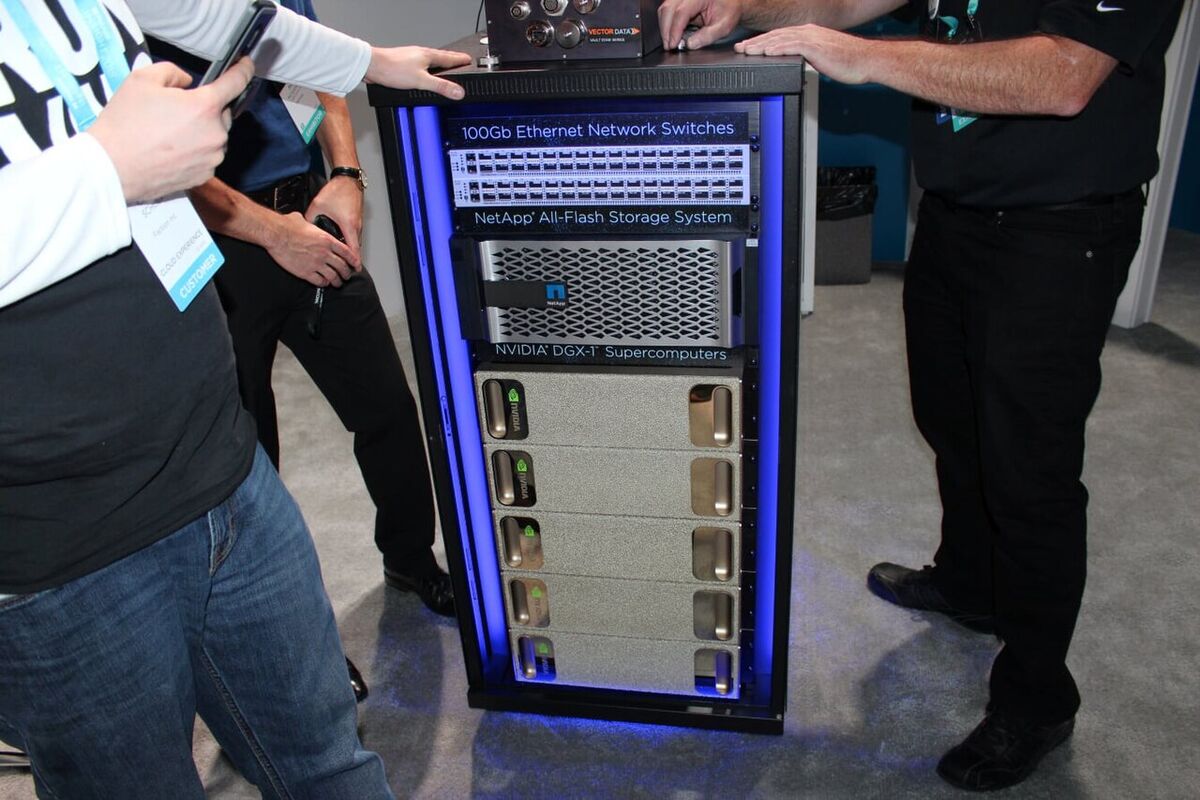
기업들은 고밀도 프라이빗 AI 클러스터에 막대한 자본을 투자하고 있습니다. 로컬 모델 학습과 추론에서 발생하는 엄청난 열을 식히기 위해, 프라이빗 코로케이션 시설에 수냉식(Liquid-cooled) 서버 랙을 도입하는 기업들이 급증하고 있습니다. 초점은 "이 클라우드 API를 어떻게 연동할까?"에서 "우리만의 GPU 클러스터를 어떻게 안전하고 효율적으로 오케스트레이션할까?"로 이동했습니다.
소버린 AI를 구축하려면 무엇이 필요할까?
소버린 AI 구축은 결코 쉬운 일이 아닙니다. 초기 하드웨어 도입에 막대한 자본이 필요하며, 프라이빗 클러스터를 관리할 전문 인력과 자체적으로 모델을 파인튜닝할 수 있는 높은 수준의 운영 성숙도가 요구됩니다.
하지만 지적재산권, 국가 안보, 또는 강력한 규제를 받는 데이터를 다루는 조직에게 소버린 AI는 더 이상 선택 가능한 사치품이 아닙니다. 2026년의 질문은 더 이상 "AI가 이 일을 할 수 있는가?"가 아니라 "그 생각하는 뇌를 실제로 소유하고 있는 것은 누구인가?"입니다.
올해가 저물어갈수록, 퍼블릭 모델에 맹목적으로 의존하는 기업들과 자신만의 안전하고 고도로 최적화된 소버린 AI의 해자(Moat)를 구축한 기업들 사이의 격차는 더 크게 벌어질 것입니다.