멀티모달 AI(Multimodal AI): 기계에게 '보고 듣고 이해하는 법'을 가르치다
- Artificial Intelligence, Technology
- Exien
- · 수정
멀티모달 AI는 텍스트만이 아니라 이미지, 오디오, 비디오 같은 여러 형태의 데이터를 하나의 모델에서 동시에 받아들이고 이해하는 AI입니다. 2026년 현재 멀티모달 AI는 업계의 기본 표준이 되었고, GPT-4V(Vision), 구글 제미나이(Gemini), 클로드 3(Claude 3) 같은 모델들은 다양한 데이터를 동시에 흡수하고 이해하며 생성해 냅니다. 그 결과 AI는 인간이 세상을 인지하는 방식과 훨씬 더 가까워졌습니다.
AI는 왜 텍스트를 넘어서야 했나?
텍스트만으로는 인간이 보고 듣는 정보의 상당 부분을 담을 수 없기 때문입니다. 생성형 AI 붐의 초기 단계에서 GPT-3와 같은 모델들은 철저히 '단일 모달(Unimodal)'이었습니다. 오직 텍스트로만 묻고 텍스트로만 답할 수 있었습니다. 이들이 에세이를 쓰거나 코드를 작성하는 능력은 경이로웠지만, 세상을 이해하는 방식에는 근본적인 한계가 있었습니다. 아름다운 저녁 노을의 색감이나, 복잡하게 얽힌 기계 설계도의 구조를 오직 '글'로만 설명한다고 상상해 보십시오. 수많은 미묘한 뉘앙스와 직관적인 정보가 증발해 버릴 것입니다.
인간은 결코 텍스트 하나만으로 세상을 인지하지 않습니다. 우리는 태생적으로 '멀티모달(Multimodal)'적인 존재입니다. 눈으로 보고, 귀로 듣고, 글을 읽으며, 주변의 맥락(Context)을 동시에 종합하여 환경을 파악합니다. 범용 인공지능(AGI)에 가까워지기 위해, AI 역시 인간과 같은 방식으로 진화해야만 했습니다.
멀티모달 AI란 무엇인가?
멀티모달 AI 시스템은 여러 가지 '모달리티(Modality, 데이터의 형태나 매체)'에서 동시에 정보를 추출하여 깊이 있는 문맥을 형성하도록 설계된 인공지능입니다.
과거에는 AI가 이미지를 분석하게 하려면, 물체를 식별하는 전용 '컴퓨터 비전 모델'을 써서 "강아지", "프리스비" 같은 텍스트 태그를 먼저 추출해야 했습니다. 그리고 이 텍스트 태그를 다시 언어 모델(LLM)에 전달했습니다. 이런 파편화된 방식은 요소들 사이의 풍부하고 의미론적인 연결고리를 유실하게 만들었습니다.
반면, 네이티브(Native) 멀티모달 AI는 모든 것을 하나의 통합된 신경망 아키텍처 안에서 한 번에 처리합니다. 사용자가 식재료가 엉망으로 섞여 있는 냉장고 내부 사진을 찍어 올리며 "이걸로 저녁에 뭘 만들어 먹을 수 있을까?"라고 물으면, 멀티모달 AI는 단순히 재료의 이름만 나열하지 않습니다. 사진 속 식재료의 시각적 상태를 파악하고, 자신의 텍스트 기반 레시피 지식과 결합하여 맥락에 맞는 요리법을 대답합니다.
멀티모달 AI는 어떻게 작동하나?
멀티모달 AI는 모든 데이터 형태를 '공유 임베딩 공간(Shared Embedding Space)' 안에 함께 배치하는 방식으로 작동합니다.
머신러닝에서 '임베딩(Embedding)'이란, 사람이 이해하는 데이터를 컴퓨터가 이해할 수 있는 수학적 벡터(숫자의 배열)로 변환하여 그 '의미'를 표현하는 방법입니다. 멀티모달 모델은 학습 과정에서, 데이터의 형태(모달리티)가 달라도 그것이 가리키는 '개념'이 같다면 고차원의 수학적 공간에서 매우 가까운 위치에 모이도록 훈련받습니다.
예를 들어, "강아지"라는 텍스트, 강아지가 짖는 오디오 파일, 골든 리트리버의 사진은 모두 각각의 벡터로 변환됩니다. 모델은 방대한 텍스트, 오디오, 이미지를 '동시에 엮어서(Jointly)' 학습했기 때문에, 이 세 가지 완전히 다른 입력값이 모두 '개념적으로 동일한 강아지'를 가리킨다는 것을 학습합니다. 이러한 공유된 표현 덕분에 AI는 모달리티의 벽을 넘나들며 추론(Reasoning)할 수 있습니다.
2026년 멀티모달 AI로 무엇을 할 수 있나?
여러 데이터 타입을 동시에 처리하는 능력은 AI 애플리케이션의 새로운 지평을 열었습니다.
1. 시각 장애인을 위한 접근성 도구
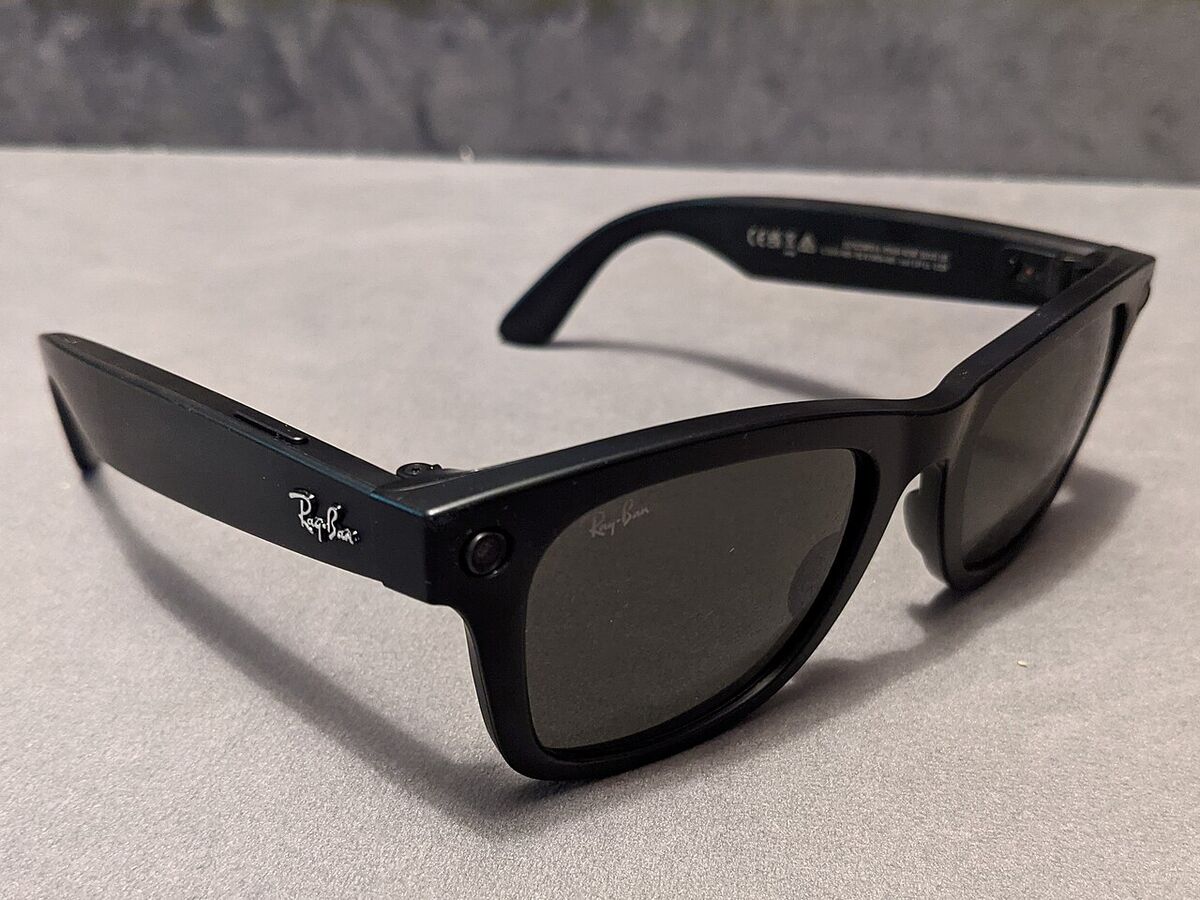
멀티모달 AI는 시각 장애인들의 일상을 바꾸고 있습니다. 카메라가 장착된 스마트 안경을 쓰면, AI가 실시간 대화형 가이드 역할을 할 수 있습니다. 식당의 메뉴판을 읽어주고, 방의 구조와 가구 배치를 묘사하며, 지폐의 권종을 식별해 줍니다. "앞에 횡단보도 신호등이 초록불로 바뀌었어?" 같은 질문에도 대답하여 일상의 자립을 돕습니다.
2. 의료 진단 보조
의사들은 환자의 텍스트 기반 과거 진료 기록, 심장 박동 소리를 녹음한 오디오 파일, 흉부 X-ray 시각 자료를 멀티모달 AI에게 한 번에 입력할 수 있습니다. AI는 이 서로 다른 유형의 데이터를 교차 분석하여, X-ray 사진 하나만 보는 전문의가 놓칠 수 있는 상관관계를 찾아낼 수 있고, 의료진의 판단과 함께 쓰일 때 더 이른 시점의 정확한 진단에 도움이 될 수 있습니다.
3. 차세대 맞춤형 교육과 튜터링
기하학 문제를 풀다 막힌 학생은, 자신이 손으로 그린 수학 숙제 사진을 찍어 AI에게 보낼 수 있습니다. 멀티모달 AI는 학생의 필기체를 읽어내고, 도형 다이어그램의 구조를 파악한 뒤, 텍스트와 음성으로 단계별 풀이 과정을 안내합니다. 지치지 않는 개인 과외 선생님이 생기는 셈입니다.
4. 콘텐츠 제작 및 비디오 분석
영상 편집자나 마케터들은 수백 시간 분량의 원본 영상을 일일이 돌려볼 필요가 없습니다. 검색창에 "발표자가 빨간 차 옆에 서서 친환경에 대해 이야기하는 장면을 찾아줘"라고 입력하면 됩니다. 멀티모달 AI는 영상의 시각적 요소(빨간 차, 사람)와 오디오 대본(친환경 이야기)을 동시에 이해하여 해당 클립을 찾아냅니다.
멀티모달 AI가 직면한 과제는?
멀티모달 시스템은 텍스트 전용 모델보다 구축과 운영이 훨씬 어렵고 비쌉니다.
- 천문학적인 컴퓨팅 비용: 고해상도 비디오나 오디오를 분석하고 생성하는 것은 텍스트 처리와는 비교할 수 없을 정도로 방대한 컴퓨팅 파워와 메모리를 요구합니다. 이는 모델 학습 및 운영(Inference) 비용의 급증으로 이어집니다.
- 복합적 환각(Complex Hallucinations): 텍스트에서의 환각도 문제지만, 멀티모달 AI의 환각은 훨씬 치명적입니다. 이미지 속의 사물을 잘못 인식하여 위험한 행동을 유도하거나, 실제로 말한 적 없는 딥페이크 오디오를 사실처럼 생성해 낼 경우, 가짜 뉴스와 보안에 미치는 악영향은 매우 큽니다.
- 데이터 편향성의 강화: 이 모델들은 방대한 쌍(Pair) 데이터(예: 이미지를 묘사한 텍스트)로 학습합니다. 만약 인간이 만든 학습 데이터에 특정 인종이나 성별에 대한 편견이 섞여 있다면, 모델은 특정 시각적 특징을 편향된 텍스트 개념과 강하게 연관 지어 학습하게 됩니다.
멀티모달 AI는 어디로 향하나?
텍스트 전용 LLM에서 '멀티모달 AI'로의 진화는 범용 인공지능(AGI)을 향한 여정에서 중요한 이정표입니다. 서로 다른 데이터 형태 사이의 장벽을 허묾으로써, 기계는 인간의 현실 세계를 채우고 있는 풍부하고 다면적인 태피스트리(Tapestry)를 감각하고 이해하기 시작했습니다. 이 모델들이 더욱 효율화되고 보편화됨에 따라, 우리가 컴퓨터와 상호작용하는 방식은 딱딱한 키보드 타이핑에서 벗어나 시각, 청각, 언어가 어우러진 자연스러운 대화로 진화할 것입니다.